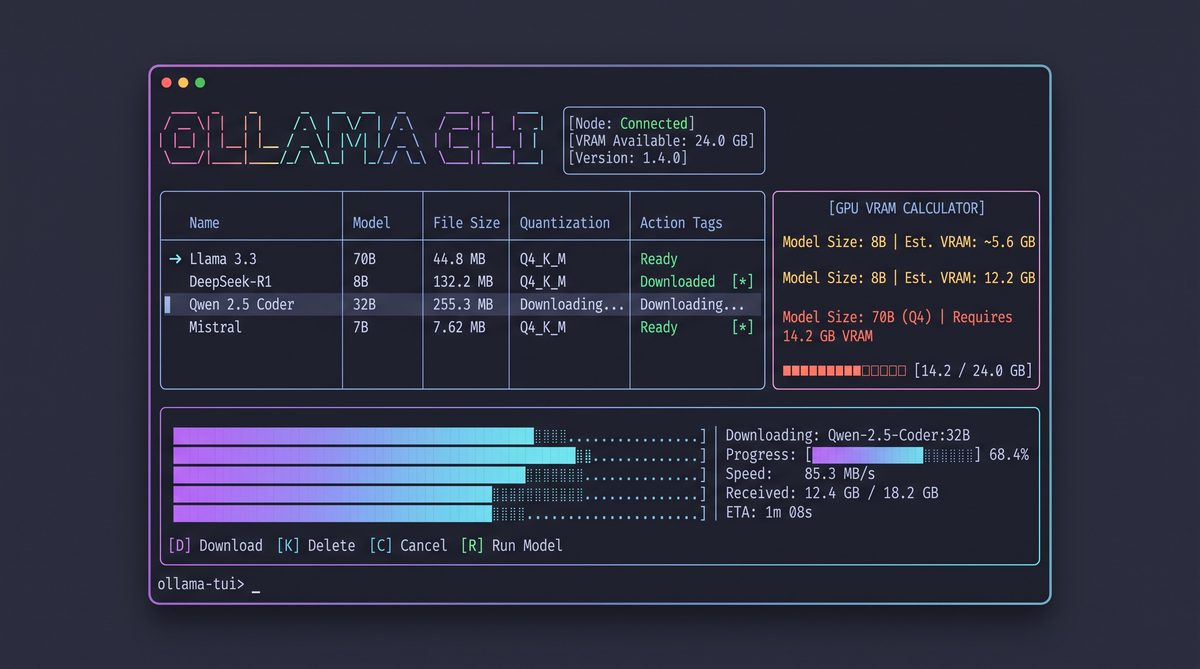
ترمینال Ollama TUI
محیط ترمینال پیشرفته مبتنی بر TUI جهت پایش، دانلود و اجرای مدلهای زبانی بزرگ محلی (مانند LLaMA 3.3، DeepSeek-R1، Qwen 2.5 Coder) با قابلیت تخمین دقیق حافظه گرافیکی (VRAM)، مدیریت کوانتیزاسیونهای مختلف، مانیتورینگ سرعت تولید توکن در ثانیه و دانلود موازی در خط فرمان.
چه مانع یا چالشی نیاز به حل داشت؟
۱. پیچیدگی مدیریت مدلهای مختلف در ترمینال: مدیریت دهها مدل زبانی با نسخههای مختلف کوانتیزاسیون (مانند 8B، 14B، 32B) و فایلهای کانفیگ Modelfile از طریق دستورات طولانی CLI باعث پیچیدگی و خطاهای مکرر میشود. ۲. خطاهای سرریز حافظه گرافیکی (CUDA OOM): اجرای مدلهای حجیم بدون محاسبه قبلی لایههای قابل انتقال به GPU منجر به کرش ناگهانی سیستم و پر شدن رم گرافیک در طول پروسه استنتاج میگردد. ۳. نبود داشبورد تعاملی در محیطهای سرور و Headless: عدم دسترسی به ابزاری سبک و بصری در سرورهای لینوکسی فاقد GUI برای بررسی نرخ تولید توکن (Tokens/sec)، میزان اشغال VRAM و وضعیت حافظه موقت کانتکست (KV-Cache).
معماری سیستم و نحوه پیادهسازی
• معماری سبک خط فرمان مبتنی بر Textual و Rich: ساخت رابط کاربری مدرن در خط فرمان با پشتیبانی کامل از کلیدهای میانبر، جستجوی زنده (Fuzzy Search) و قابلیت انطباق خودکار با ابعاد گوناگون ترمینالهای لینوکس و مک. • الگوریتم محاسبهگر هوشمند حافظه گرافیکی (VRAM): پیادهسازی فرمول تخمین وزن لایهها، بافر پنجره کانتکست و مصرف حافظه KV-Cache برای انواع کوانتیزاسیونها پیش از بارگذاری مدل جهت جلوگیری از خطای کمبود حافظه. • کلاینت ناهمگام ارتباط با سوکت محلی Ollama: برقراری ارتباط سریع از طریق سوکت و REST API لوکال جهت پایش بلادرنگ توکنهای تولیدی در ثانیه، میزان بار پردازشی و دانلود پسزمینه مدلها با نمایش نوار پیشرفت چندبخشی.
ارزش ایجاد شده
• مدیریت و سوییچ سریع میان بیش از ۴۰ مدل زبانی محلی تنها با یک کلید و بدون نیاز به تایپ دستورات مکرر. • حذف کامل خطاهای سرریز حافظه گرافیکی با بهرهگیری از الگوریتم پیشبینی مصرف VRAM قبل از بارگذاری مدل. • پایش لحظهای و زنده نرخ سرعت استنتاج (Tokens/sec) و نمایش بازدهی پردازشگر گرافیکی به صورت زنده.
نیاز به پیادهسازی سیستمی مشابه دارید؟
برای مشاوره فنی، امکانسنجی یا توسعه پروژههای استخراج داده و هوش مصنوعی در ارتباط باشید.